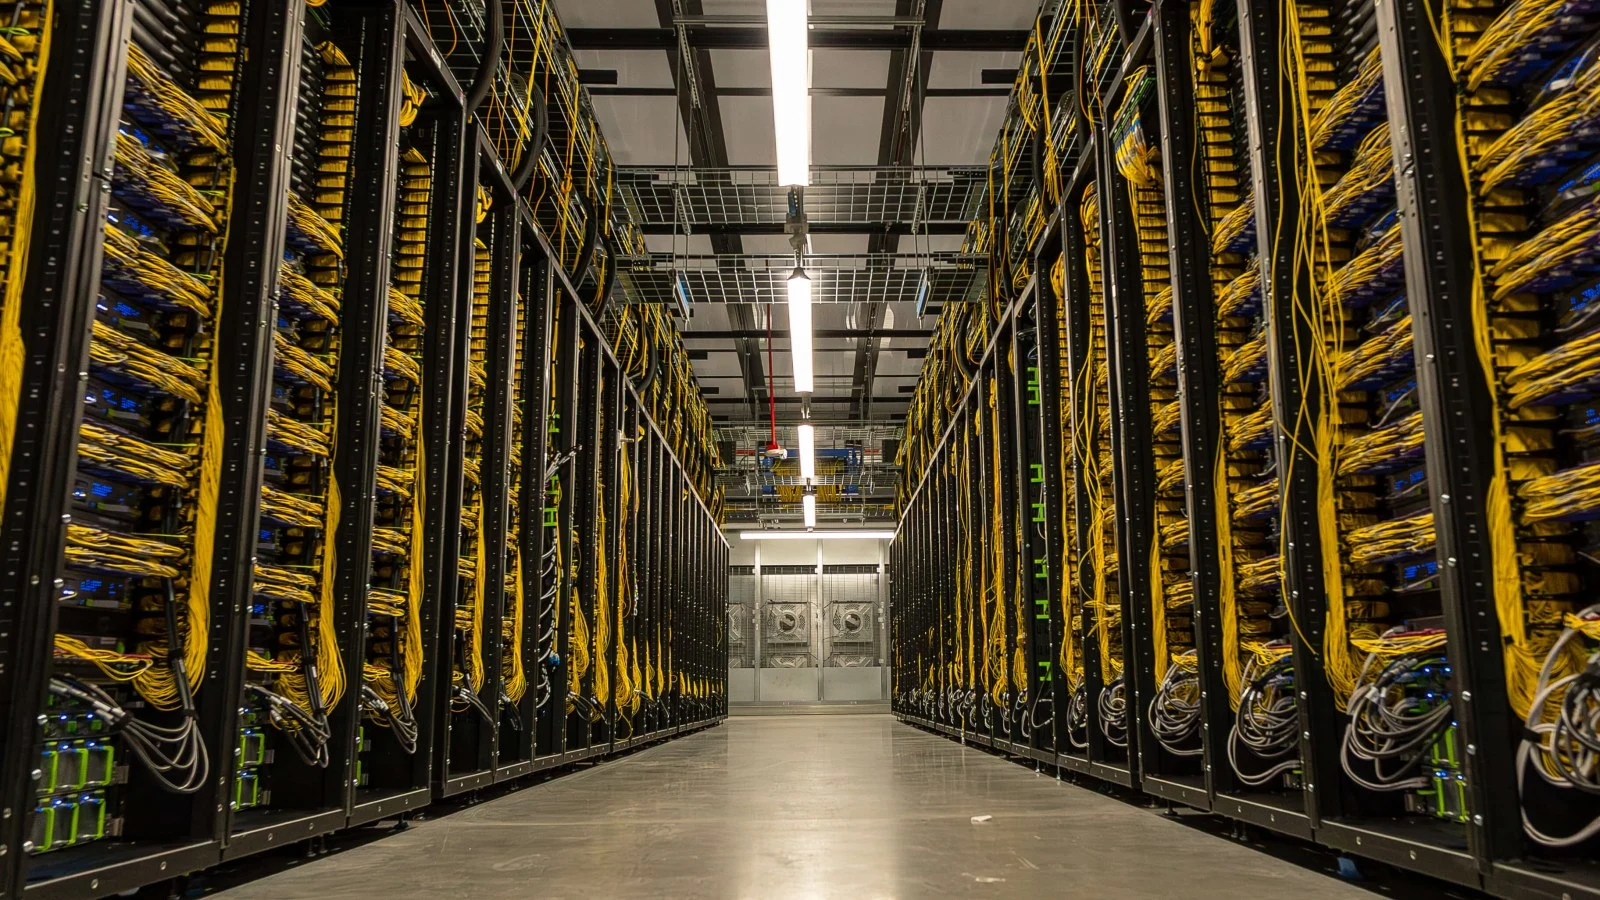
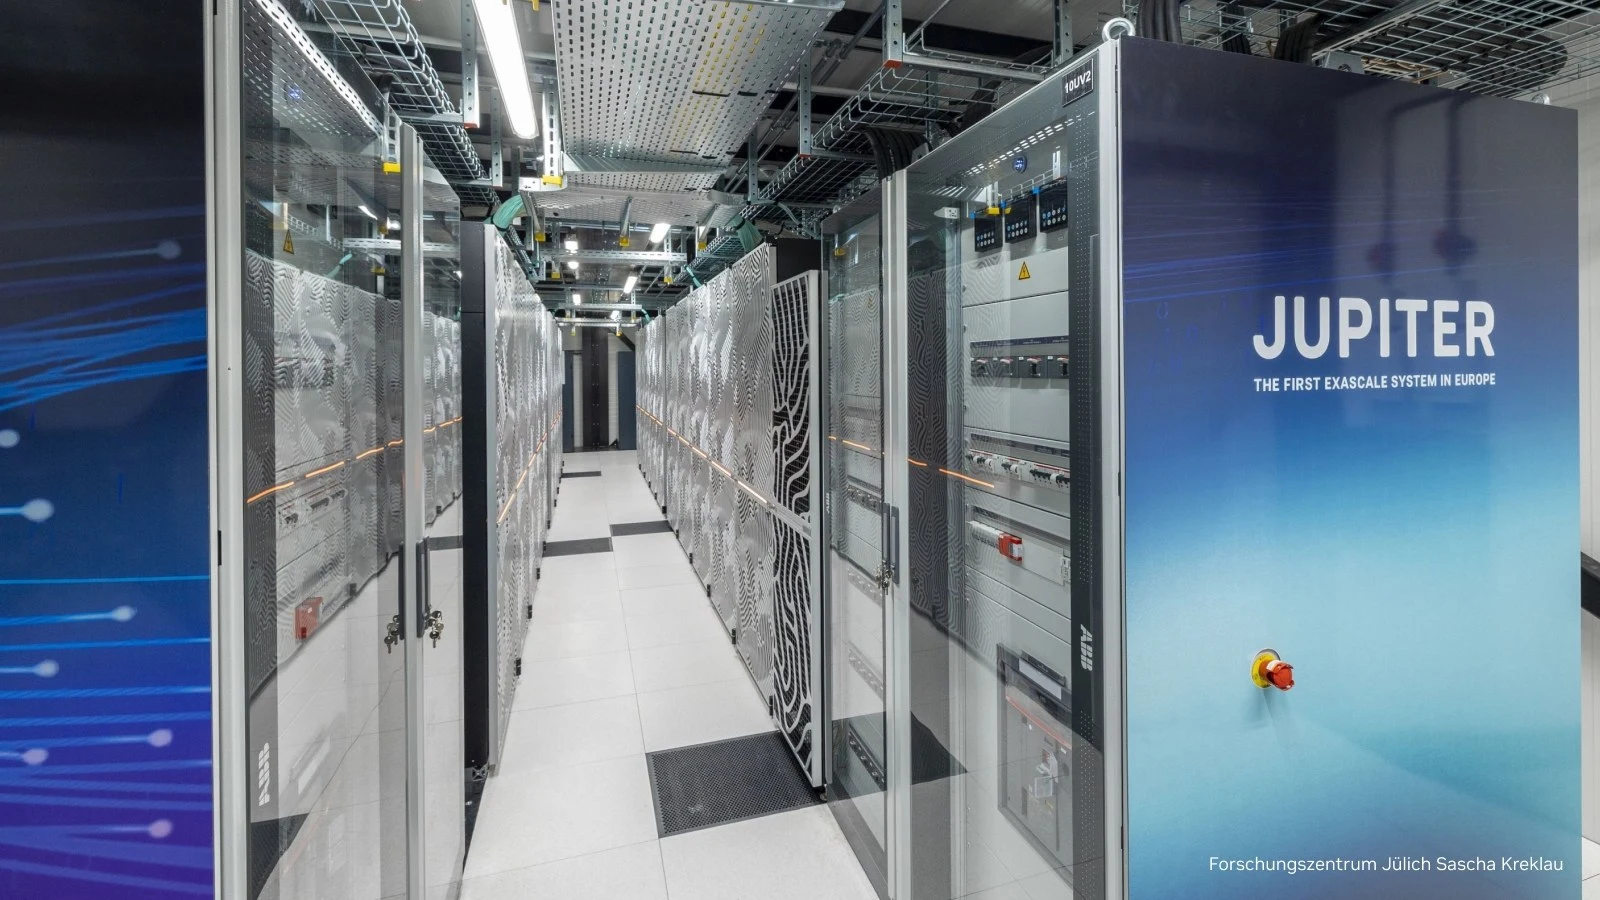
Meta, yapay zekâ modellerini eğitmek için kurduğu dev altyapının ayrıntılarını kapsamlı biçimde paylaştı. Şirketin mühendislik blogunda 19 Ekim'de yayımlanan yazıya göre Prometheus adlı süper küme, ABD'nin Ohio eyaletindeki New Albany'de bulunuyor ve gigawatt ölçeğinde tasarlandı. Kümenin ilk aşaması tamamlandı ve Muse Wonder dahil Muse temel modellerinin eğitiminde kullanıldı.
Yüz binlerce GPU, hedef 1 milyon
Meta'nın açıklamasına göre Prometheus bugün birbirine bağlı birden fazla binada yüz binlerce GPU barındırıyor. Tam ölçeğe ulaştığında yaklaşık 1 milyon GPU'nun eş zamanlı çalışması hedefleniyor. Kümede üç farklı rack platformu yer alıyor:
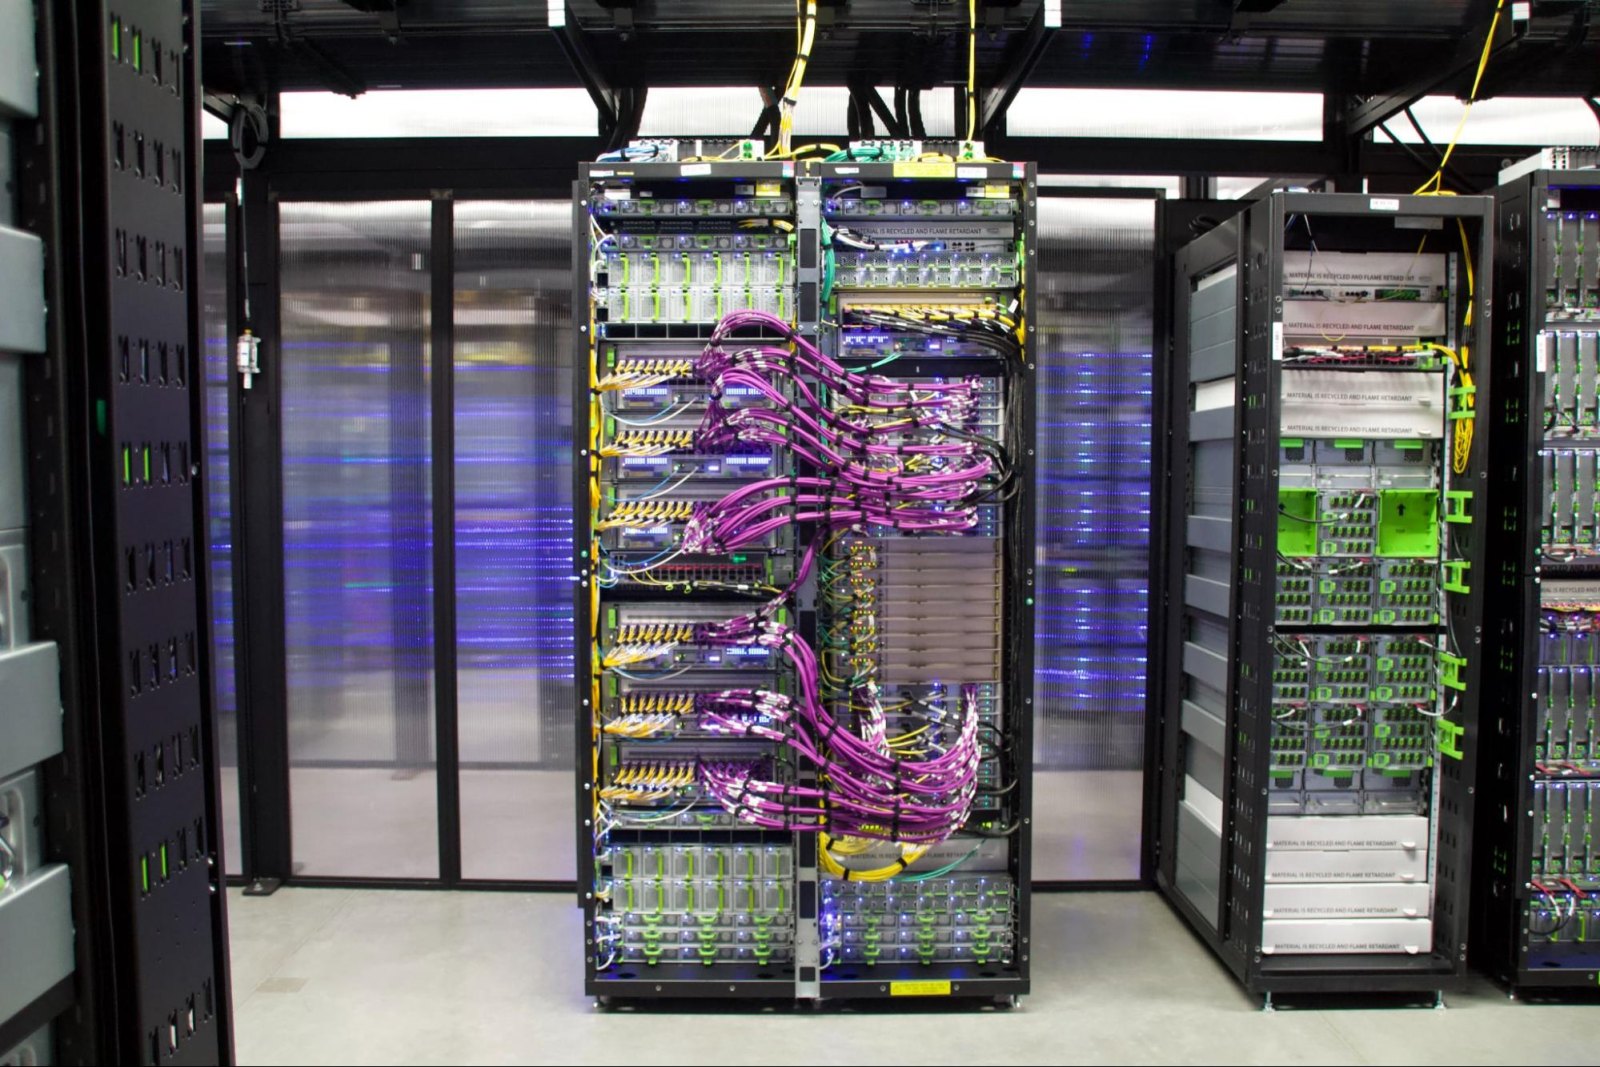
- Catalina: NVIDIA GB200 NVL72 tabanlı, iki rack'e yayılmış 72 GPU, GPU başına 192 GB HBM3e ve rack çifti başına yaklaşık 120 kW güç.
- Clemente: GB300 NVL72 tabanlı, tek rack'te 72 Blackwell Ultra GPU, GPU başına 288 GB HBM3e ve yaklaşık 135 kW güç.
- San Miguel: Yakında devreye girecek Vera Rubin NVL72 platformu; GPU başına 288 GB HBM4 ve 170 kW'ı aşan tamamen sıvı soğutmalı rack'ler.
Ağ ve güvenilirlik
Meta'ya göre her bina içi ağ dokusu 20.736 GPU'ya kadar bağlanabiliyor. Binalar arasındaki trafik için Broadcom Jericho3 tabanlı Arista 7800 şasileri kullanılırken, yaklaşık 10 km'yi aşan bağlantılarda 800G-ZR optikler devreye giriyor. Şirket, kümede on binlerce anahtar ve milyonlarca optik bileşen bulunduğunu belirtiyor.
Bu ölçekte arızalar kaçınılmaz olduğu için Meta güvenilirliğe ayrı bir başlık ayırıyor. Yazıya göre 2025 ortasında 8 bin GPU başına günde neredeyse 1.000'e ulaşan kesinti sayısı, bir yıllık mühendislik çalışmasıyla yüzde 99 azaltıldı. Muse Wonder ön eğitiminde verimli çalışma oranı yüzde 85'in, pekiştirmeli öğrenme çalışmalarında yüzde 90'ın üzerine çıktı. Her rack'te 64 GPU aktif çalışırken 8 GPU yedekte tutuluyor.
Güç dalgalanmaları ve soğutma
Meta, eş zamanlı eğitimin yüzde 30-40'a varan ani yük değişimlerine yol açabildiğini, işlerin başlaması ya da durmasıyla saniyeler içinde onlarca megavatlık oynamalar yaşandığını aktarıyor. Bunun için GPU güç sınırlarını kademeli ayarlayan Dynamo Dimmer adlı bir yönetim sistemi geliştirildi. Soğutmada hava destekli sıvı soğutma ile tesis düzeyinde sıvı soğutma birlikte kullanılıyor. Şirket, edindiği deneyimlerin Louisiana'da kurulacak Hyperion süper kümesinin tasarımına aktarıldığını da belirtiyor.
Meta'nın paylaştığı verilere göre GB200 NVL72 rack çifti FP8'de 720 petaflop tepe performansa ulaşırken, GB300 NVL72 rack'i FP4'te 1 exaflop'un üzerine çıkıyor ve öncülüne göre yüzde 5-10 performans artışı sunuyor. Şirket, bakım tarafında ise bellenim (firmware) güncellemelerini birkaç saat içinde 100 binden fazla GPU'ya dağıtabilen bir otomasyon geliştirdiğini belirtiyor.
Kaynak: Meta
Yorumlar 0
Henüz yorum yok. İlk yorumu sen yaz.
Yorum yaz